摘要:HyperFlow H3 Flash 把约 31B 的 MiniMax-H3 transformer 压缩到 13.7B,6 步采样、无需 CFG,输出 13 2026-11-12 05:57:0 Author: blog.upx8.com(查看原文) 阅读量:1 收藏
摘要:HyperFlow H3 Flash 把约 31B 的 MiniMax-H3 transformer 压缩到 13.7B,6 步采样、无需 CFG,输出 1344×768 视频并同步生成 32kHz 立体声。本文基于官方模型卡、ComfyUI 节点 README 和官方基准文档,整理部署清单、内存与显存要求、真实耗时和授权限制。
先给结论
| 问题 | 答案 |
|---|---|
| 是什么 | MiniMax-H3 的压缩少步版,由 Video Rebirth 开发,不是 MiniMax 官方产品 |
| 参数量 | fl2va 13.7B、ref2va 13.9B,约为原版 transformer 的一半不到 |
| 压缩方法 | 结构剪枝(丢块)+ 低秩分解 + 旋转 W8A8 INT8(convrot)+ 双时间 (t, r) 条件 |
| 采样 | 4 / 6 / 8 步,默认 6 步,CFG = 1.0,不用负面提示词 |
| 输出 | 24 fps,默认 1344×768,5.2–15 秒(124–362 帧),32kHz 立体声同步音轨 |
| RTX 4090 能跑吗 | 能。官方基准:24GB 显卡跑 5.2 秒文生视频约 152 秒,峰值显存 23 GiB |
| 16GB 显存呢 | 官方明确写「16 GB GPUs are not measured yet」,没有验证 |
一句话:它把「能不能在消费级显卡上跑」变成了「要等多久」,但还谈不上一键秒出片。
规格一览
| 项目 | 数值 |
|---|---|
| 基础模型 | MiniMax-H3(约 31B transformer) |
| 压缩后 | fl2va 13.7B / ref2va 13.9B |
| 剪枝细节 | fl2va 丢弃 50 个块中的 3 个(6/21/22),分解 102 个线性层;ref2va 丢 1 个(9),分解 114 个 |
| 采样 | euler + BasicGuider,cfg = 1.0 |
| 分辨率 | 32 的倍数,默认 1344×768,支持 768×1152 竖屏 |
| 帧数 | 17n + 5,124 帧(5.2 秒)到 362 帧(15 秒) |
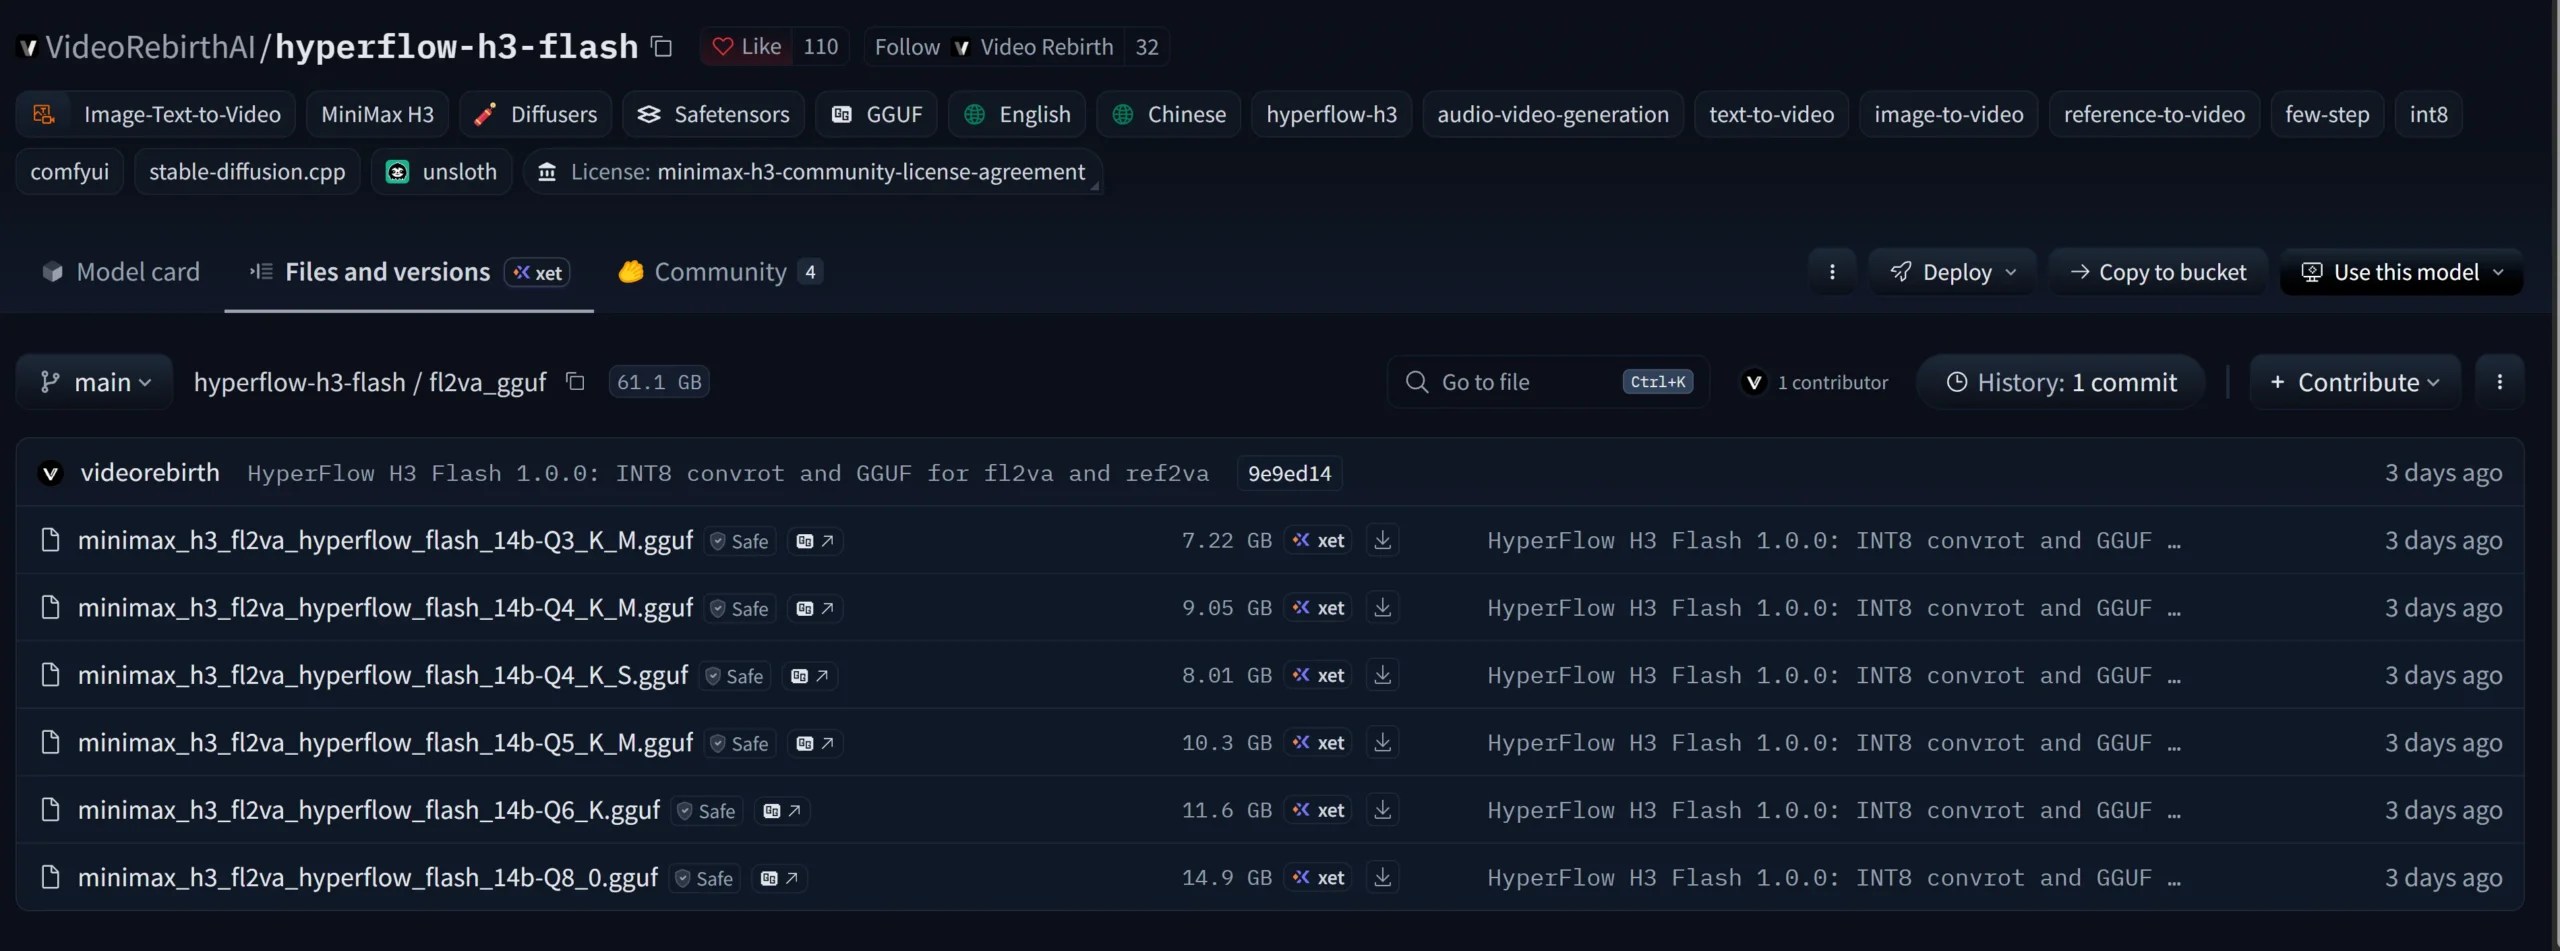
| 权重体积 | GGUF Q3_K_M–Q8_0 约 7.2–15.2 GB(Q4_K_M 9.1 GB,Q8_0 14.9 GB);INT8 convrot 约 16 GB |
参考输入(ref2va) |
最多 9 张图、3 段视频、3 段音频,合计 12 个参考 |
部署四步
1. 升级 ComfyUI
官方节点要求 ComfyUI 0.43.0 及以上(带原生 MiniMax-H3 支持),官方基准跑在 0.44.0。直接升级到最新版即可,不必卡某个小版本。下载:https://comfy.org/download/
走 INT8 路线时还需要 --enable-triton-backend,或使用 CUDA 13.0+ 编译的 PyTorch,否则会退回 PyTorch INT8 fallback,速度慢约 50%。

2. 安装节点
GGUF 路线(两个节点):
cd ComfyUI/custom_nodes
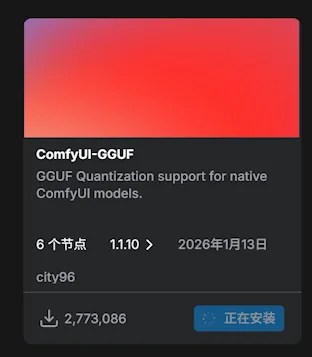
git clone https://github.com/city96/ComfyUI-GGUF
git clone https://github.com/Video-Rebirth/ComfyUI-HyperFlow-Flash
pip install -r ComfyUI-HyperFlow-Flash/requirements.txt   # 在 ComfyUI 的 Python 环境里执行
INT8 路线(一个节点): 只装 ComfyUI-HyperFlow-Flash,不需要 ComfyUI-GGUF。节点包需 1.1.0 或更新,HyperFlow Loader 会自动识别带 hyperflow 元数据的 INT8 safetensors。普通 loader 不认双时间嵌入和分解后的线性层,不要混用。

3. 放置模型文件(3 + 1)
HyperFlow 只压缩了主扩散网络,文本编码器、视频 VAE、音频 VAE 沿用 MiniMax-H3,所以是 3 个共用组件 + 1 个 HyperFlow 主权重:
ComfyUI/models/
├── diffusion_models/
│   ├── minimax_h3_fl2va_hyperflow_flash_14b-Q4_K_M.gguf               # fl2va GGUF
│   ├── minimax_h3_fl2va_hyperflow_flash_14b-int8_convrot.safetensors   # 或 INT8
│   └── minimax_h3_ref2va_hyperflow_flash_14b-Q4_K_M.gguf              # ref2v 用,可选
├── text_encoders/
│   └── qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors                   # 约 15.7 GB
└── vae/
    ├── minimax_h3_video_vae_fp16.safetensors                           # 约 5.21 GB
    └── minimax_h3_audio_vae_fp32.safetensors                           # 约 605 MB
下载来源(建议只用官方):
- 主权重:https://huggingface.co/VideoRebirthAI/hyperflow-h3-flash
- 文本编码器与两个 VAE:https://huggingface.co/Comfy-Org/MiniMax-H3
4. 选工作流
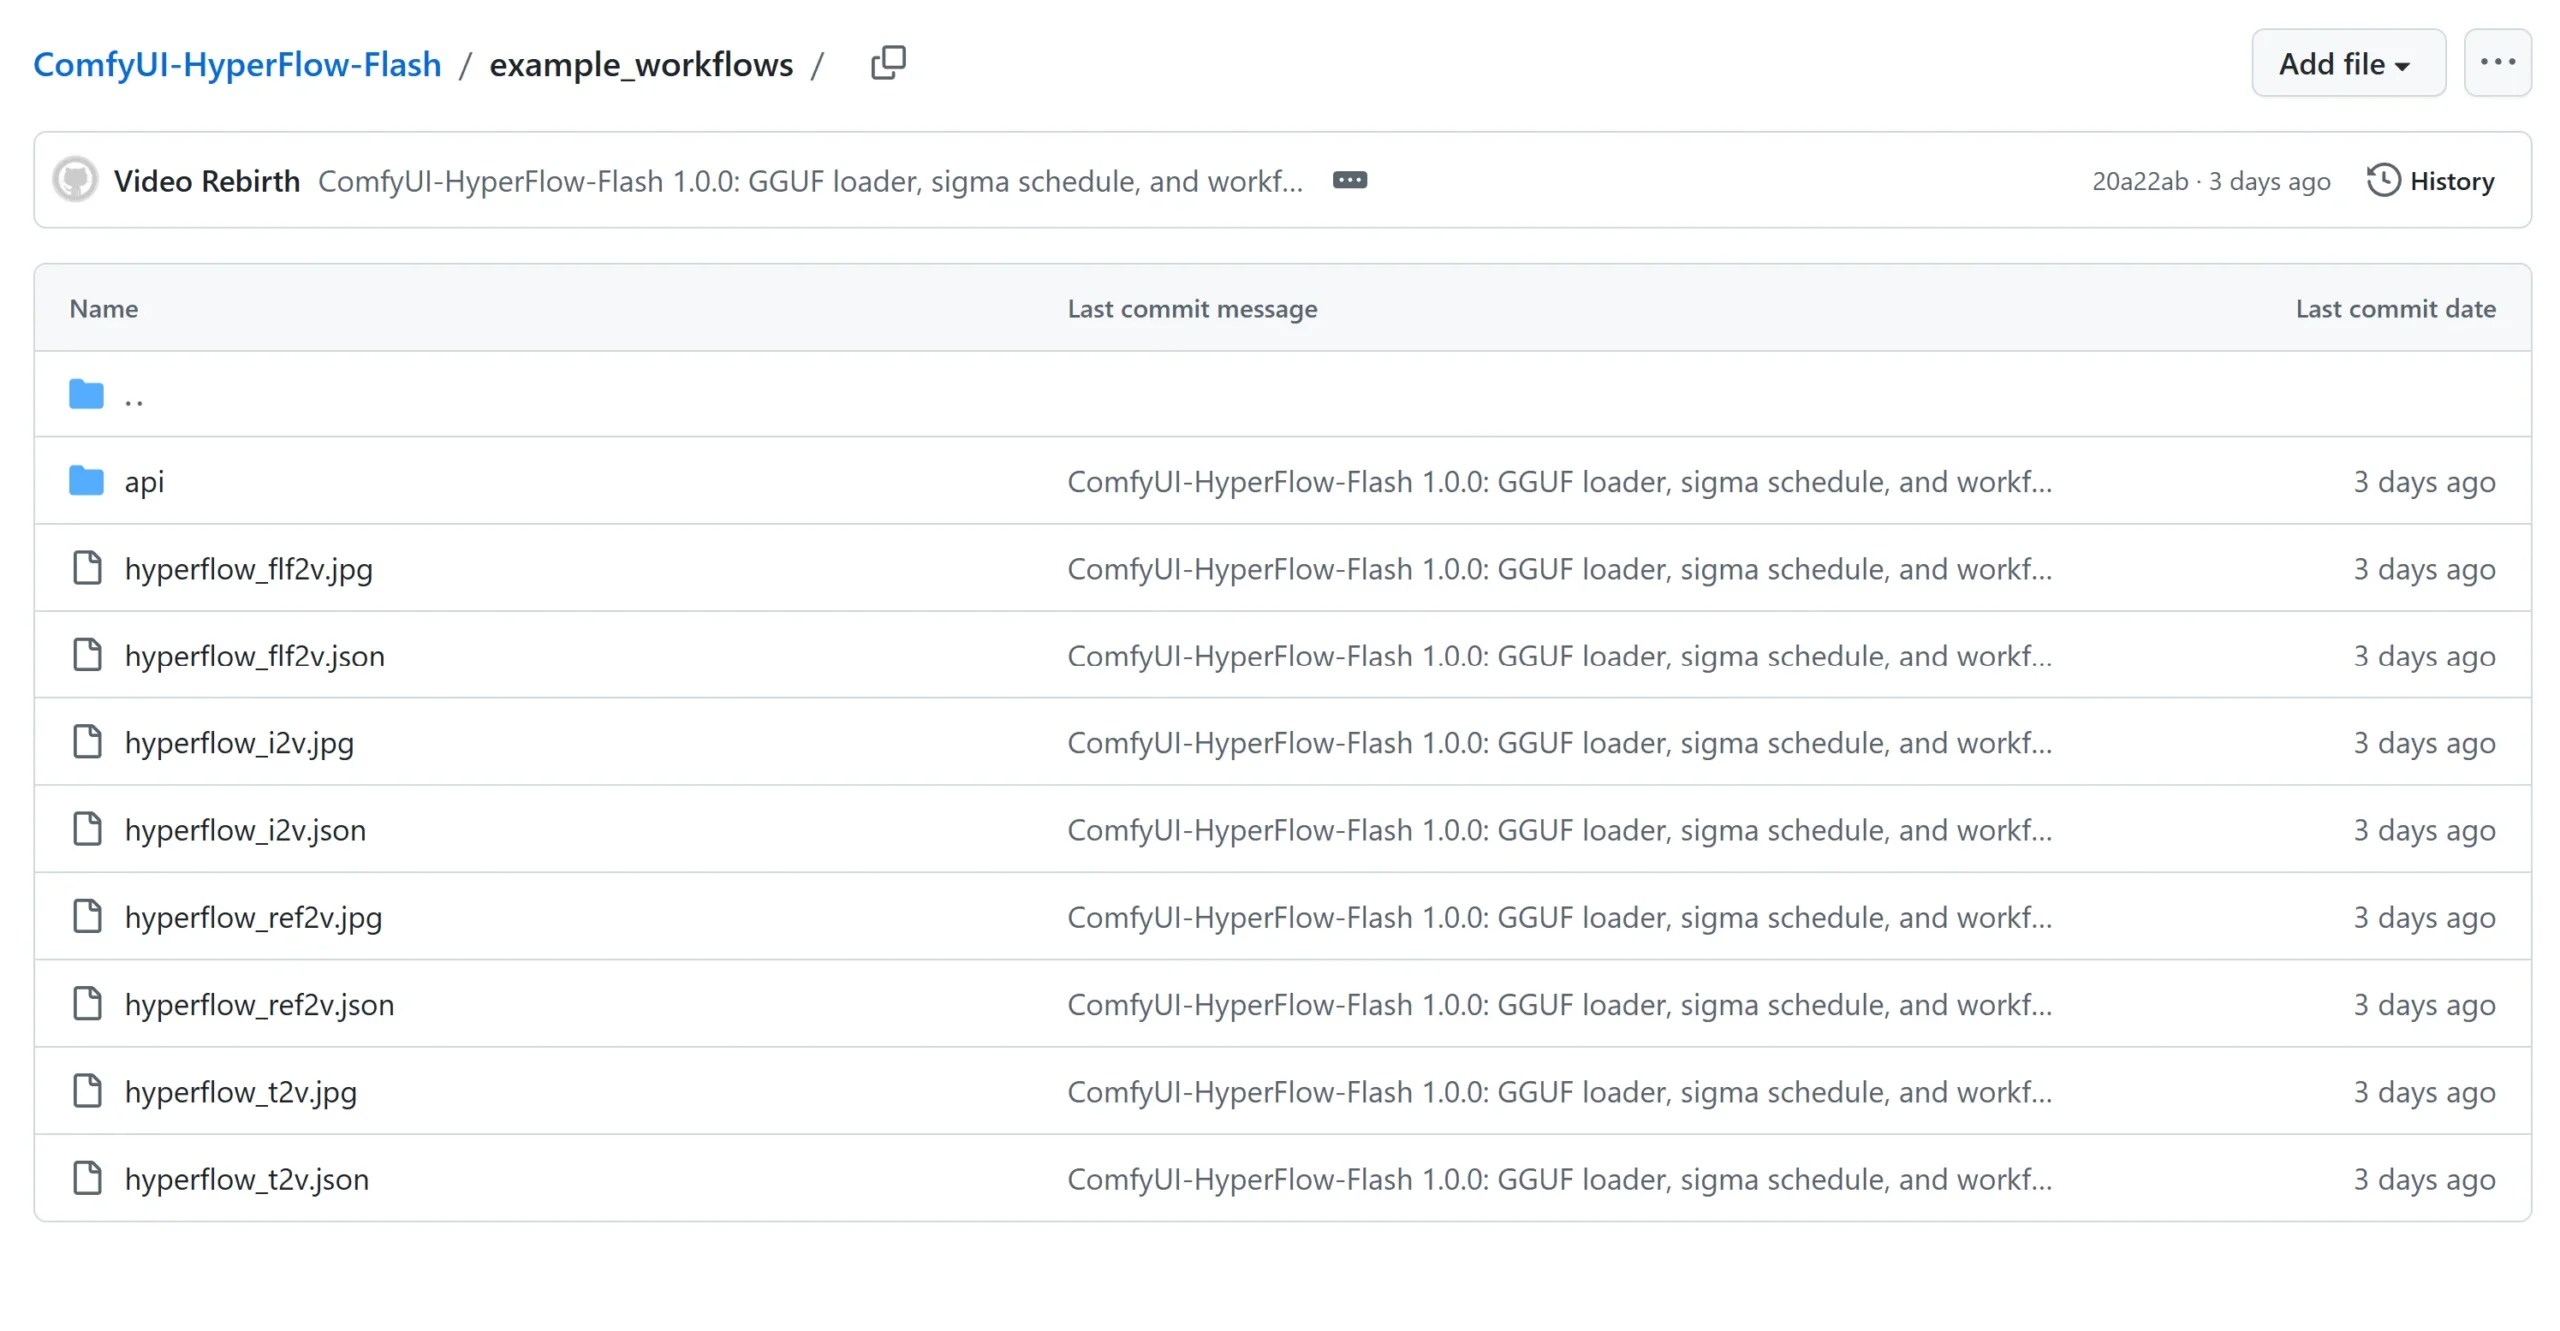
装好节点后,在 ComfyUI 的 Workflow → Browse Templates → ComfyUI-HyperFlow-Flash 能直接看到官方模板,也可以把 JSON 拖进画布。
| 文件 | 任务 | 所需 transformer |
|---|---|---|
hyperflow_t2v.json |
文生音视频 | fl2va |
hyperflow_i2v.json |
首帧图生音视频 | fl2va |
hyperflow_flf2v.json |
首尾帧控制 | fl2va |
hyperflow_ref2v.json |
多图/角色参考 | ref2va |
官方地址:https://github.com/Video-Rebirth/ComfyUI-HyperFlow-Flash/tree/main/example_workflows
GGUF 与 INT8 各有一套,文件名带 _int8 的是 INT8 版。另有社区维护的 INT8 工作流(含稀疏注意力版本):https://huggingface.co/BennyDaBall/HyperFlow-H3-Flash-INT8-ComfyUI/tree/main/workflows ,其帧数、时长和加速幅度以工作流内节点参数为准,目录页未提供官方数据。

工作流导出的 MP4(保存在 ComfyUI/output/hyperflow/)内嵌了工作流元数据,把 MP4 拖回 ComfyUI 就能还原整张图。
关键参数
prompt:把画面、运动、镜头运动、声音写进同一条提示词,不要负面提示词。width/height:32 的倍数,横屏 1344×768,竖屏 768×1152。length:17n + 5,124 帧 ≈ 5.2 秒,362 帧 = 15 秒。steps:在 HyperFlow Sigmas 节点里选 4 / 6 / 8,默认 6。- 采样器保持
euler,BasicGuider的cfg = 1.0。 ref2va:GGUF 与 ComfyUI INT8 路线只接受图片参考,视频和音频参考需要 Python 包。提示词里用<Picture 1>、<Picture 2>指代参考图。- 每张参考图都会给每一步增加 token。
ref_image_size默认match,改成max后,2048 的图片会让 5.2 秒片段耗时翻倍。
官方基准:到底要等多久
条件:Q4_K_M GGUF + qwen3vl_32b_minimax_h3_nvfp4_awq,1344×768,6 步,--fast-disk,32GB 内存配置。
| GPU | 帧数 / 时长 | t2v | i2v | flf2v | ref2v(2 图) | 峰值显存 |
|---|---|---|---|---|---|---|
| RTX 4090 24GB | 124 / 5.2s | 152 s | 166 s | 178 s | 180 s | 23 GiB |
| RTX 5090 32GB | 124 / 5.2s | 99 s | 108 s | — | 139 s | 28 GiB |
| RTX 5090 32GB | 294 / 12.2s | 426 s | 439 s | — | — | 23 GiB |
| RTX 5090 32GB | 362 / 15.0s | 609 s | 624 s | — | 663 s | 23 GiB |
ref2v 峰值显存单独计:4090 为 22 GiB,5090 为 30 GiB。
另一组端到端 t2v 数据(ComfyUI 0.44.0,PyTorch 2.13 + CUDA 13.0,不含保存 MP4,格式为 5.2 秒 / 15 秒):
| GPU / 系统内存 | INT8 safetensors | Q4_K_M GGUF | Q8_0 GGUF |
|---|---|---|---|
| RTX PRO 6000 96GB / 188GB | 53 s / 333 s | – | – |
| RTX 5090 32GB / 60GB | 83 s / 518 s | 96 s / 562 s | 98 s / – |
| RTX 4090 24GB / 31GB | 152 s / 747 s | 160 s / 834 s | 173 s / – |
| RTX 4090 24GB / 16GB PC | 153 s / 821 s | 163 s / – | – |
INT8 在 5.2 秒 t2v 上的峰值显存:PRO 6000 为 39 GiB,5090 为 31 GiB,4090 为 21 GiB。
怎么读这些数据: 4090 出 5 秒片段约两分半,出 15 秒要十二分钟以上。「快」是相对原版几十步采样而言。质量方面,官方给出的 PSNR(对比 BF16 GGUF,同 seed)为 INT8 18.0 dB、Q8_0 17.5 dB、Q4_K_M 14.8 dB,量化越低,画面偏离越大。
INT8 与 GGUF 的采样速度差距不大(H200 上 INT8 198 s,Q8_0 192 s,BF16 194 s),INT8 的价值主要在省内存和不依赖 ComfyUI-GGUF,而不是数量级提速。
系统内存与 --fast-disk
官方的分档看的是系统内存,不是显存:
| 系统内存 | 启动方式 | 行为 |
|---|---|---|
| ≥ 64 GB | python main.py |
模型常驻内存(峰值 RSS 34–39 GiB),重复生成最快 |
| 32 GB | python main.py --fast-disk |
匿名 RSS 8–16 GiB,比不限内存慢约 5%(5090 约 13%) |
| 16 GB | python main.py --fast-disk |
匿名 RSS 约 8 GiB,其余交给 OS 页缓存 |
Windows 便携版在 run_nvidia_gpu.bat 里改为:
.\python_embeded\python.exe -s ComfyUI\main.py --windows-standalone-build --fast-disk
使用建议:
- 用
--fast-disk时模型放在 NVMe SSD 上,未缓存的层会在各阶段反复读盘。 - INT8 safetensors 在 16GB 内存的 PC 上(留 12 GiB 给 ComfyUI)可以不加
--fast-disk,官方在 5090 和 4090 上验证过。GGUF 建议加,4090 上还要补--disable-cuda-malloc(默认 CUDA allocator 跑 15 秒Q4_K_M会崩)。 - Windows 跑 15 秒长片段时,任务管理器「性能 → 内存」里「已使用」应低于物理内存,「已提交」一旦超过就会换页,每一步都变慢。
两个 INT8 专属坑
- 内核后端:ComfyUI 用 comfy-kitchen 跑 INT8 线性层。CUDA 后端要求 PyTorch 编译于 CUDA 13.0+,Triton 后端需要
--enable-triton-backend,否则退回 PyTorch fallback,慢约 50%。 - 2³¹ 元素上限:Triton INT8 内核用 32 位偏移,单层输出超过 2³¹ 个元素会返回错误值。
fl2va在 1344×768 下卡在 294 帧。官方HyperFlow Loader用分块行处理规避,其他 INT8 加载器有同样限制。
首尾帧用法
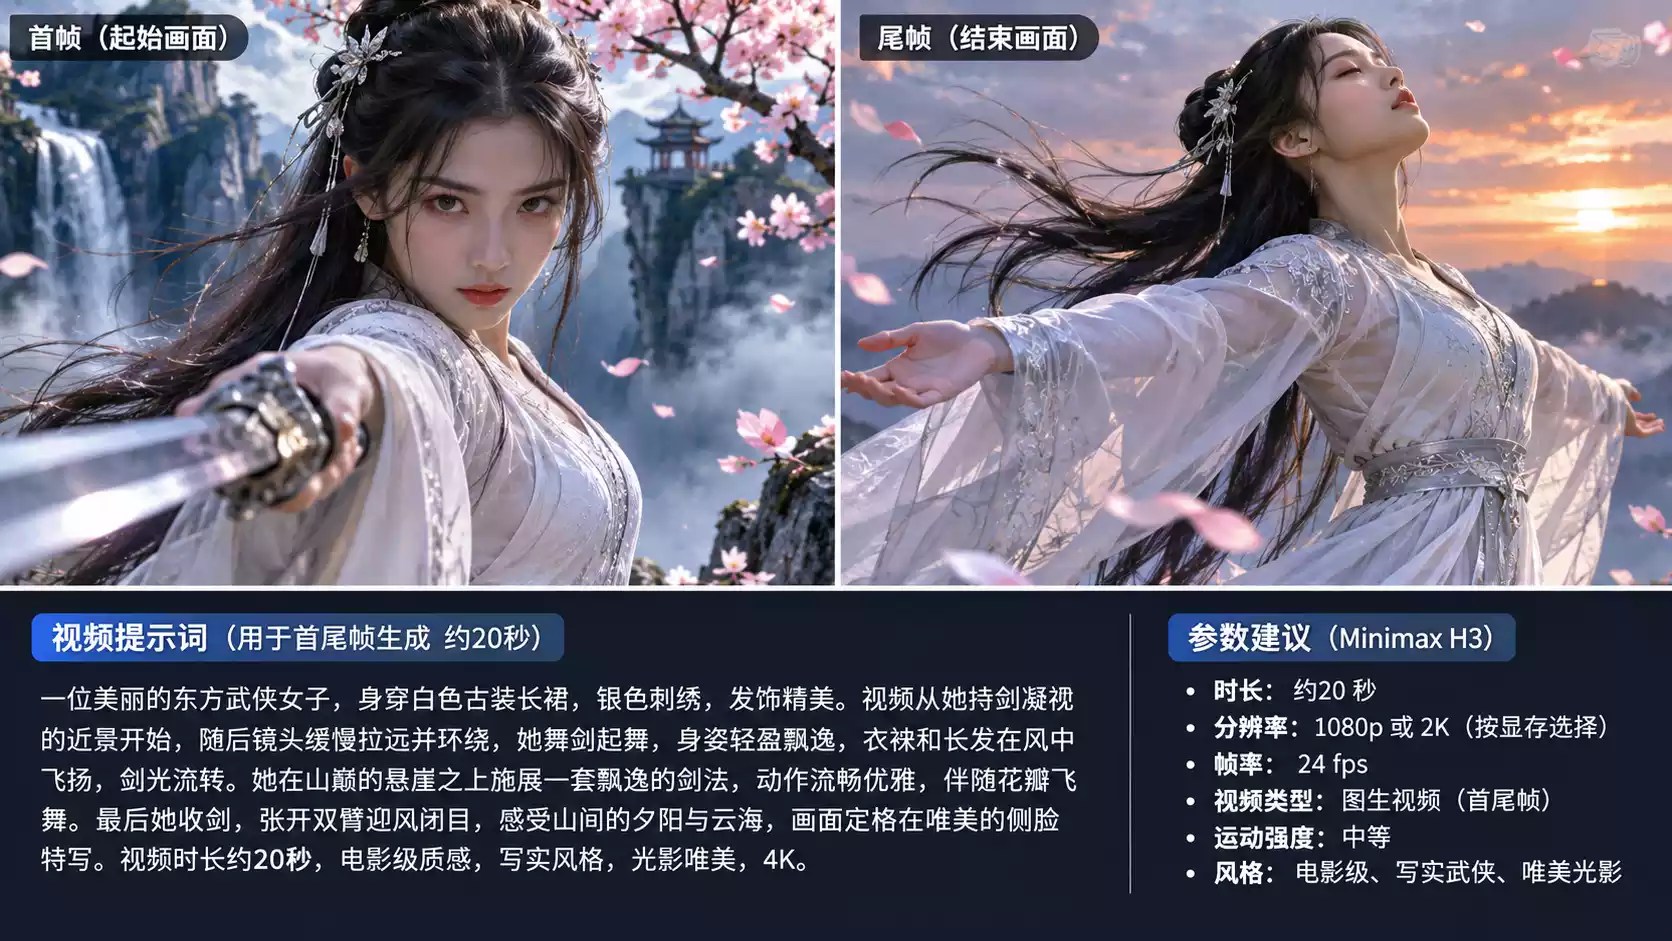
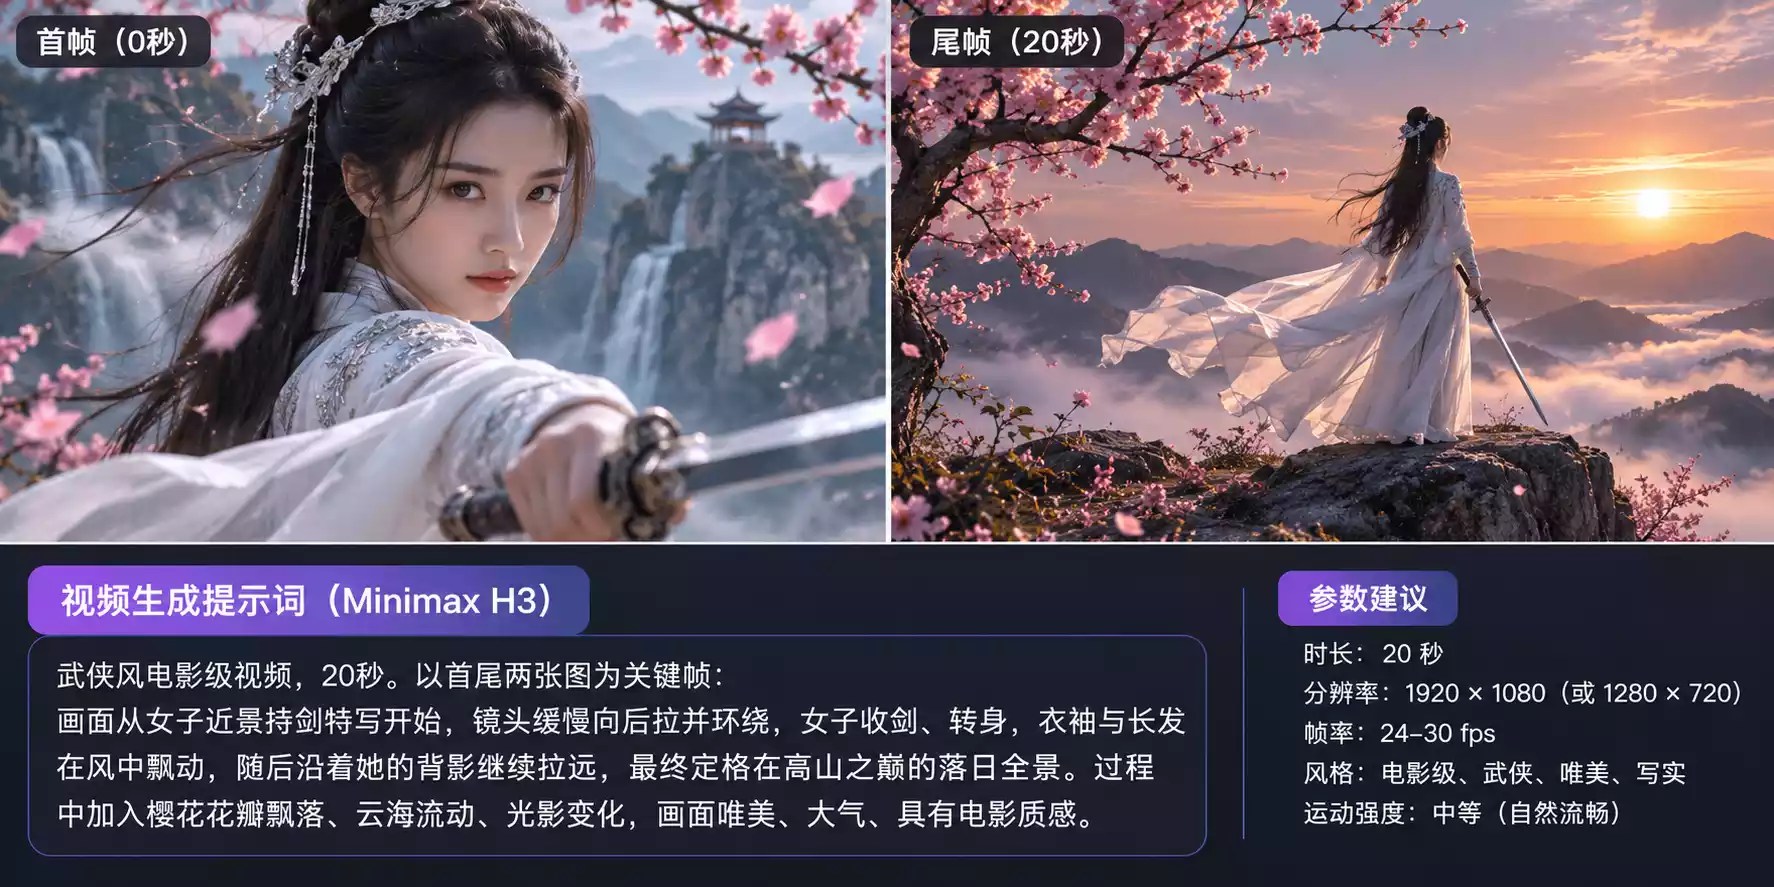
首尾帧(flf2v)的思路是:同一角色,给两个机位或姿态作为首帧和尾帧,再配一条把动作、镜头和声音写在一起的提示词,让模型补齐中间过渡。做角色连续的短片时,可以先用角色定妆图配合 ref2v 工作流保持一致,再用首尾帧控制具体镜头。

授权与合规(商用前必读)
| 对象 | 许可 |
|---|---|
| ComfyUI 节点代码 | GPL-3.0 |
| 推理代码 | Apache-2.0 |
| 模型权重 | MiniMax H3 Community License Agreement(权重属于 MiniMax-H3 的 Model Derivative,不是 GPL-3.0) |
下载或使用权重即视为接受该协议,要点:
- 地域排除:全球授权,但明确排除欧盟、英国、韩国、美国;这些司法辖区的个人或组织下载前需取得 MiniMax 事先授权。
- 可接受使用政策(AUP):公开分发生成内容必须明确标注为 AI 生成。
- 商业门槛:年营收超过 2000 万美元的产品或服务需 MiniMax 事先书面授权,产品 UI 需显著显示
MiniMax H3。 - 输出限制:生成结果不得用于训练或改进其他 AI 模型。
- 再分发:需随附协议与
NOTICE,标注被修改的文件,不得附加额外条款。
协议原文:https://huggingface.co/VideoRebirthAI/hyperflow-h3-flash/blob/main/LICENSE
常见问题
16GB 显存的卡能跑吗? 官方写的是「16 GB GPUs are not measured yet」。已验证的是 24GB(4090/3090)和 32GB(5090)。注意「16GB 系统内存 + --fast-disk」和「16GB 显存」不是一回事。
模型加载报错怎么办? 最常见三条:换成 HyperFlow Loader;INT8 权重需要节点包 1.1.0+;GGUF 路线需要安装 city96/ComfyUI-GGUF,并确认文件放在正确目录。
跑长视频崩溃? 15 秒 Q4_K_M GGUF 在 4090 上默认 CUDA allocator 会崩,加 --disable-cuda-malloc。INT8 超过 294 帧(fl2va,1344×768)会触发 Triton 32 位偏移问题,用官方 HyperFlow Loader。
能出竖屏、能加旁白吗? 竖屏可以(768×1152)。音轨由模型同步生成,声音通过提示词描述,不是后期导入旁白。
我的测试(建议补充)
在这里写你自己的硬件配置、系统内存、所用权重和实际耗时。有了自己的数据,这篇文章的原创价值会高很多。
参考来源
| 用途 | 地址 |
|---|---|
| 官方模型卡与权重 | https://huggingface.co/VideoRebirthAI/hyperflow-h3-flash |
| 官方 ComfyUI 节点 | https://github.com/Video-Rebirth/ComfyUI-HyperFlow-Flash |
| 官方基准与排错文档 | https://github.com/Video-Rebirth/hyperflow-h3-flash/blob/main/integrations/README.md |
| MiniMax-H3 共用组件 | https://huggingface.co/Comfy-Org/MiniMax-H3 |
| GGUF 加载器 | https://github.com/city96/ComfyUI-GGUF |
| 社区 INT8 工作流 | https://huggingface.co/BennyDaBall/HyperFlow-H3-Flash-INT8-ComfyUI |
| ComfyUI 下载 | https://comfy.org/download/ |
如有侵权请联系:admin#unsafe.sh