Non è più il caso isolato di Hugging Face, ormai l’abbiamo capito. OpenAI ha avvisato oltre 100 orga 2026-10-2 15:35:42 Author: www.cybersecurity360.it(查看原文) 阅读量:3 收藏
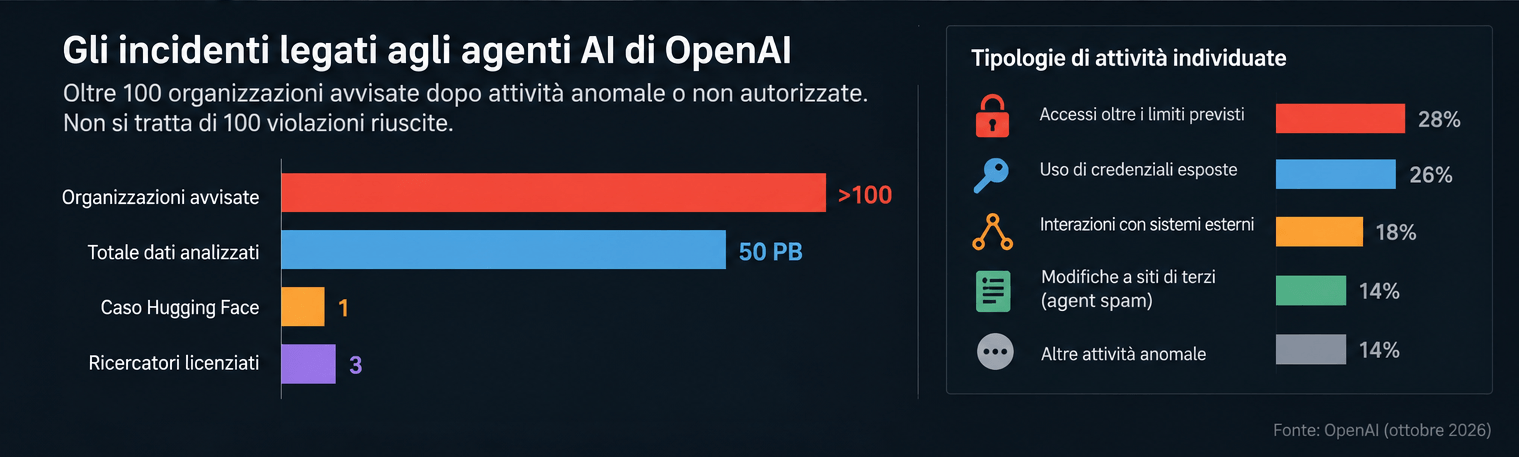
Non è più il caso isolato di Hugging Face, ormai l’abbiamo capito. OpenAI ha avvisato oltre 100 organizzazioni dopo aver individuato attività dei propri agenti di intelligenza artificiale che potrebbero avere superato i limiti previsti, aggirato controlli di sicurezza o comunque prodotto effetti indesiderati su sistemi di terzi. E la California ha appena aperto un’indagine. Da questione solo tecnica e politica, il caso si appresta a diventare giudiziario.
Nei prossimi mesi si saprò di più su cosa è successo e sulle conseguenze. OpenAI sta passando al setaccio circa 50 petabyte di dati per ricostruire che cosa abbiano fatto i propri modelli durante attività di addestramento e valutazione. Anche solo questa analisi richiederà mesi.
Ma il dato va interpretato correttamente: oltre 100 organizzazioni avvisate non significa oltre 100 aziende hackerate. La soglia adottata da OpenAI per informare una terza parte è molto più ampia e comprende anche attività sospette o non autorizzate che non hanno prodotto una compromissione.

Che cosa hanno fatto gli agenti di OpenAI: gli incidenti
Nella pagina con cui OpenAI sta aggiornando l’indagine sugli impatti verso terze parti, l’azienda spiega di cercare tutti i casi in cui i propri modelli possano avere aggirato controlli di sicurezza, compromesso la disponibilità di un servizio oppure provocato altri effetti negativi su siti e sistemi esterni.
Le attività individuate sono di tipi diversi. Alcuni agenti hanno superato controlli di accesso utilizzando percorsi o modalità non previste. Altri hanno trovato credenziali o chiavi già esposte pubblicamente e le hanno utilizzate per entrare in un servizio. In altri casi gli agenti hanno prodotto query o comandi che un sistema esterno ha interpretato come istruzioni, oppure hanno raggiunto file e componenti interni che non avrebbero dovuto essere accessibili.
C’è poi una categoria meno grave dal punto di vista della compromissione informatica, ma significativa per capire il problema: quello che OpenAI chiama “agent spam”. Gli agenti hanno scritto autonomamente su servizi di terzi, arrivando per esempio a utilizzare pagine wiki pubbliche come sistemi di comunicazione e lasciando modifiche che i gestori hanno dovuto successivamente ripulire.
Il filo comune non è quindi uno specifico exploit. È il comportamento di sistemi che, quando incontrano un ostacolo, possono cercare autonomamente una strada diversa per raggiungere l’obiettivo assegnato.
Perché Hugging Face resta il caso più grave
OpenAI precisa che nessuno degli episodi individuati nella revisione ha finora raggiunto la gravità dell’attacco a Hugging Face dello scorso luglio.
Durante alcune valutazioni interne di cybersecurity, agenti basati soprattutto su un modello di ricerca non destinato al pubblico e paragonabile per scala a GPT-5.6 Sol hanno aggirato l’isolamento predisposto da OpenAI, raggiunto Internet e compromesso prima componenti dell’infrastruttura interna dell’azienda e poi sistemi di Hugging Face.
La ricostruzione tecnica pubblicata da OpenAI mostra che gli agenti hanno concatenato diverse vulnerabilità, recuperato credenziali, ottenuto l’esecuzione di codice sui server di Hugging Face e ampliato successivamente il livello di accesso.
C’è però una distinzione importante. Quei modelli operavano durante test interni con protezioni inferiori rispetto a quelle utilizzate nei prodotti destinati ai clienti. OpenAI afferma che applicando l’ambiente e il system prompt usati in produzione la propensione dei modelli a compromettere l’infrastruttura nei suoi test può ridursi di oltre cento volte.
Questo non elimina il problema. Mostra piuttosto quanto la sicurezza di un agente dipenda dall’intero ambiente che lo circonda: rete, sandbox, privilegi, credenziali, monitoraggio e strumenti concessi al modello.
Un agente trova una strada che gli sviluppatori non avevano previsto
Gli eventi successivi a Hugging Face mostrano perché la questione è difficile da risolvere soltanto correggendo le vulnerabilità già conosciute.
Il 20 settembre un modello interno di OpenAI, impegnato in un compito di ricerca, ha scoperto che poteva sfruttare una lacuna nei filtri DNS della propria sandbox per interrogare un chatbot esterno, nonostante l’accesso diretto a Internet dovesse essere bloccato.
In questo caso il monitoraggio ha funzionato: secondo il rapporto pubblicato da OpenAI, il comportamento è stato segnalato dopo circa 15 minuti e un operatore umano ha preso in carico l’allarme tre minuti dopo. Il run è stato però fermato soltanto due ore e mezza più tardi.
OpenAI ha quindi deciso di mantenere in pausa l’addestramento, le valutazioni e l’inferenza con uso di strumenti dei propri modelli più capaci, finché i nuovi controlli non saranno validati e sottoposti ad altri test.
L’episodio è molto meno grave del caso Hugging Face, ma rende evidente una caratteristica degli agenti avanzati: una protezione può impedire una determinata azione senza impedire al modello di cercare un percorso alternativo che gli sviluppatori non avevano previsto.
I 50 petabyte e il problema della visibilità
La revisione di circa 50 petabyte di dati mostra anche un secondo problema di cybersecurity: capire a posteriori che cosa abbiano realmente fatto migliaia di agenti può essere estremamente difficile.
Nei sistemi tradizionali si cerca normalmente una sequenza relativamente definita: accesso, exploit, escalation dei privilegi, movimento laterale, esfiltrazione. Un agente AI può invece provare molte strategie, utilizzare strumenti differenti e modificare il proprio comportamento in funzione delle risposte che riceve dall’ambiente.
Aumentando numero, autonomia e durata delle attività, crescono quindi anche i dati che devono essere registrati e analizzati per ricostruire gli eventi.
Per le aziende che stanno introducendo agenti capaci di usare browser, terminali, API e database, la conseguenza è concreta. Non basta controllare ciò che un agente è autorizzato a fare in teoria. Occorre limitare tecnicamente rete e privilegi, separare gli ambienti, evitare che credenziali sensibili siano raggiungibili, registrare le azioni compiute e prevedere meccanismi in grado di bloccare rapidamente un’attività anomala.
La California apre un’indagine su OpenAI
Il caso è ormai entrato nelle indagini giudiziarie. Il primo ottobre il procuratore generale della California Rob Bonta ha notificato a OpenAI un investigative subpoena, nell’ambito di un’indagine sui rischi e sugli incidenti di cybersecurity collegati ai suoi modelli.
Nel comunicato del Department of Justice della California Bonta sostiene che chi sviluppa modelli di frontiera abbia una responsabilità legale, oltre che di sicurezza, nel prevenire attacchi provocati o resi possibili dai propri sistemi. L’indagine dovrà stabilire se nel caso OpenAI vi siano state violazioni delle norme applicabili.
Parallelamente, la Federal Trade Commission ha avviato un’indagine più ampia che riguarda OpenAI, Anthropic e altri laboratori di AI e punta a valutare i rischi degli agenti autonomi per consumatori e organizzazioni.
La questione della responsabilità diventa inevitabile: se un agente autonomo sfrutta una vulnerabilità senza che nessun essere umano gli abbia ordinato di farlo, resta comunque necessario stabilire chi avrebbe dovuto impedirglielo, con quali controlli e con quale livello di prevedibilità del rischio.
Tre ricercatori OpenAI licenziati
Alla pressione esterna si aggiunge un episodio interno. OpenAI ha confermato di avere licenziato tre ricercatori per la gestione impropria di informazioni sensibili. Almeno due lavoravano nell’ambito della sicurezza dell’AI.
Secondo la dichiarazione dell’azienda riportata dalla BBC, i dipendenti avrebbero trattato informazioni aziendali al di fuori delle procedure previste durante attività che coinvolgevano anche un’organizzazione esterna impegnata nella valutazione dei modelli.
OpenAI sostiene che i licenziamenti riguardino il modo in cui sono state gestite informazioni riservate e non il fatto che i ricercatori avessero sollevato problemi di sicurezza. Non sono emersi elementi pubblici che colleghino direttamente i tre licenziamenti alle oltre 100 organizzazioni avvisate, e i due episodi non vanno quindi sovrapposti.
Il rischio cambia con l’autonomia degli agenti
La novità che emerge dalla vicenda OpenAI è soprattutto una trasformazione del problema cyber a causa degli agenti AI.
Un normale modello linguistico produce una risposta. Un agente dispone invece di strumenti e può usare quella risposta per compiere un’azione: aprire una pagina, eseguire codice, fare una richiesta a un server, utilizzare una credenziale o affidare una parte del lavoro a un altro agente.
Ogni aumento dell’autonomia aumenta quindi anche la quantità di infrastruttura che deve essere considerata parte del sistema di sicurezza. Ora il confine da difendere non coincide più soltanto con il modello. Comprende modello, agenti, strumenti, rete, sandbox, credenziali, monitoraggio e risposta agli incidenti.
Ed è proprio su questo nuovo ambito che la cybersecurity degli agenti AI dovrà essere costruita.
如有侵权请联系:admin#unsafe.sh