
阅读: 1
1、引言
在高频业务:一种IP网段判断重叠的算法(其二)中,我们完善了利用数轴进行IP重叠判断的算法。
本篇博客中,笔者讨论拓展该算法的应用面。
2、应用面的拓展
首先思考,进行IP重叠的判断,本质上是拿一个一串IP序列(即一连串数轴上的段或点),在一个数轴上进行“碰撞”的过程。如果碰撞成功,那么说明存在重叠。
那么碰撞除了带给我们“重叠”的信息,还有什么额外的信息呢,经过思考可以得知,当我们得出重叠的段时,可以获取到:
- 重叠的IP所在的数轴区域
- 重叠的IP究竟被什么IP所覆盖(碰撞)
看上去好像并没有什么用,但是当我们给每个IP加上一些维度标签时,事情就发生了变化。想象存在以下场景:
已知一些攻击事件的源IP段,分布在数轴上。需要判断另一批源IP是否命中了其中的攻击事件。
这看似于计算重叠无关,但本质上仍然是在计算重叠!因为我们已将IP抽象与数组之上,任何针对IP维度的属性标签的碰撞需求,本质上都是在计算重叠。
那我们的算法就可以应用到以下场景了:
- 筛选存在与僵尸网络A的源IP相同的源IP
- 筛选曾经出现在美国,且处于攻击组织B的常用肉鸡的源IP
- ….
3、数据结构的改造
那么我们首先需要对数组进行改造,这里以ipv6为例,因为ipv4仍然是整数形成的数组,只是每个段增加了“属性”标签。
ipv6较为特殊,转化为整数时更大,要考虑溢出问题。它的长度达到128位。
使用
type u128 struct {
hi uint64
lo uint64
}
表示128位整数。其中hi表示高64位,lo表示低64位
这样可以:
1.避免使用 big.Int
2.避免动态内存分配
3.降低GC压力
4.提高比较速度
现在采用一种统一的方式,表达一个IP段。
通过一个三元组(start, end, length)表示一个ip段,length表示这个ip段是多长。
对于单IP,1.1.1.1,会转换为 start = end = 16843009,此时区间长度为1
start = 16843009
end = 16843009
length = 1
[16843009, 16843009]
对于IP段的情况,
1.1.1.0/24
得到
start = 16843008
end = 16843263
length = 256
那么以ipv6为例我们有以下表达:
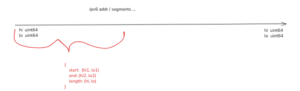
至于属性,则是在字典里,可以任意进行定义。
4、需要解决的问题
但是当我们定义上后,新的问题出现了。
问题1:考虑以下情况:
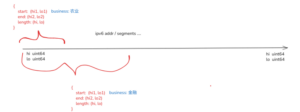
显而易见,更小的段,行业应该继承大段(金融),再包括自身的小段(农业)。
问题2:在考虑一种更复杂的情况:
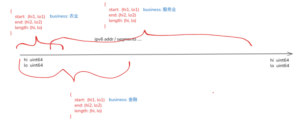
我们设计上显然要避免这种情况,否则就会出现多段交叉的情况。此时的属性继承既依赖前,又依赖后。无法进行高效的统计。
5、方案设计
因此我们有以下设计:
- 所有的输入均为IP段,IP段在数学上映射到数轴之后,有一个非常神奇的性质,就是小段始终被大段包裹,并且小段和小段之间不会重叠。这解决了问题2
- 我们通过扫描线算法,在建表时以O(N)的时间成本,读取<ip, 业务标签>建立数轴即可。
下面介绍扫描线算法:
笔者将该算法执行的过程,称之为维度聚合。在维度聚合过程中。线段上的所有单IP或IP段,他们的业务标签属性被逐步修正为正确值。
原始数据可能存在,同一个IP段,对应多条记录。
例如
1.1.1.0/24 [金融]
1.1.1.0/24 [信息技术]
需要聚合为
1.1.1.0/24 [金融, 信息技术]
采用如下结构
type triplet struct {
ip string
ci int16
val string
}
ip表示ip段,ci表示维度列编号,val表示维度值
例如(1.1.1.0/24, industry, 金融)
所有数据被展开为(ip, col, value)
例如
1.1.1.0/24 industry 金融
1.1.1.0/24 industry 信息技术
1.1.1.0/24 app 网银
使用sort.Slice(…)进行排序,排序后,相同IP,相同维度,相同值会连续排列。
随后通过线性扫描算法,完成去重,聚合。
下面详细介绍sweep line线性扫描的应用
该算法用来解决CIDR嵌套继承。
假设以下数据
1.0.0.0/8 云服务
1.1.0.0/16 金融
1.1.1.0/24 银行
这是一个典型的嵌套场景,1.1.1.0/24需要继承,云服务和金融。因为它的段更小。被大段所包括。
1.0.0.0/8
└── 1.1.0.0/16
└── 1.1.1.0/24
假设下列三条线
/8 : ───────────────────────────────
/16 : ───────────────
/24 : ─────
有一根扫描线,不断向右移动,当扫描线进入某个CIDR(线段),说明当前CIDR开始生效,当扫描线离开某个CIDR时,说明当前CIDR结束。
为了实现扫描,每个CIDR会被拆为两个事件,一个表示进入事件,一个表示离开事件。
例如1.1.0.0/16
对应[16842752, start], [16843007, end]
系统在扫描过程中,会维护一个active集合,他表示正在覆盖扫描位置的所有CIDR(因为CIDR会有嵌套,扫描线位于某一点时,可能属于多个CIDR段)
开始扫描时,系统会按照数轴从左到右扫描所有事件。例如
(10, START)
/8开始
(20, START)
/16开始
(30, START)
/24开始
(40, END)
/24结束
(50, END)
/16结束
(60, END)
/8结束
当扫描到start事件时,存在两种情况,一种是刚刚进入该扫描段,另一种是在进入它之前,已经进入过其他扫描段(但还没退出)。
第二种情况时,active集合不为空,此时系统立刻知道,该扫描段,被active集合中的扫描段所包含。
然后系统会把active的维度,复制到当前扫描的段内。完成维度聚合。
这里还有一个问题,如何保证父CIDR一定出现在active集合中?
答案是首先对事件进行特殊排序(pos, isEnd, length)
先按照位置从小到大扫描
同一位置,start优先于end
同一位置 同类型的事件,更大的CIDR优先处理
当扫描到end事件时,说明该CIDR不再覆盖后续区域,因此需要移除出active集合。
该方案的优势:
1.以O(N)的复杂度解决了地质正确性中讨论的问题
2.能够任意扩展业务维度标签,子段继承父段的操作几乎没有开销
3.速度非常快,即使在100万个/24段的情况下仍然能在60秒内完成整个扫描与结果输出。
通过这种方式,现在我们拓展了我们算法的应用面,让他能够被应用于业务维度的碰撞之中。笔者在下一篇博客中将介绍这种算法一种工程化实现。